مقدمهای بر عصر هوش مصنوعی و یادگیری ماشین
در دنیای امروز که دادهها به عنوان "نفت جدید" شناخته میشوند، یادگیری ماشین (Machine Learning) به عنوان یکی از ستونهای اصلی تحول دیجیتال، نقش بسیار حیاتی ایفا میکند. یادگیری ماشین فراتر از یک مفهوم ساده است؛ این علم در واقع تلاش برای ساخت سیستمهایی است که بدون برنامهنویسی صریح، از تجربه و دادهها میآموزند. برخلاف برنامهنویسی سنتی که در آن قوانین به صورت صریح توسط انسان نوشته میشوند، در یادگیری ماشین ما الگوریتمها را با دادهها تغذیه میکنیم تا آنها خود قوانین، الگوها و روابط پنهان را کشف کنند.
هدف نهایی یادگیری ماشین، ایجاد مدلهایی است که بتوانند بر اساس دادههای گذشته، پیشبینیهای دقیق انجام دهند یا تصمیمات هوشمندانه بگیرند. این تکنولوژی اکنون در همه جای زندگی ما حضور دارد؛ از سیستمهای پیشنهاددهنده در نتفلیکس و یوتیوب گرفته تا تشخیص چهره در گوشیهای هوشمند و خودروهای خودران.
تعاریف و مفاهیم بنیادین: تفکیک هوش مصنوعی، یادگیری ماشین و یادگیری عمیق
بسیاری از افراد این سه اصطلاح را به جای هم به کار میبرند، اما در واقعیت آنها روابط سلسلهمراتبی با یکدیگر دارند. درک این تفاوت برای هر متخصص دادهای ضروری است.
هوش مصنوعی (Artificial Intelligence)
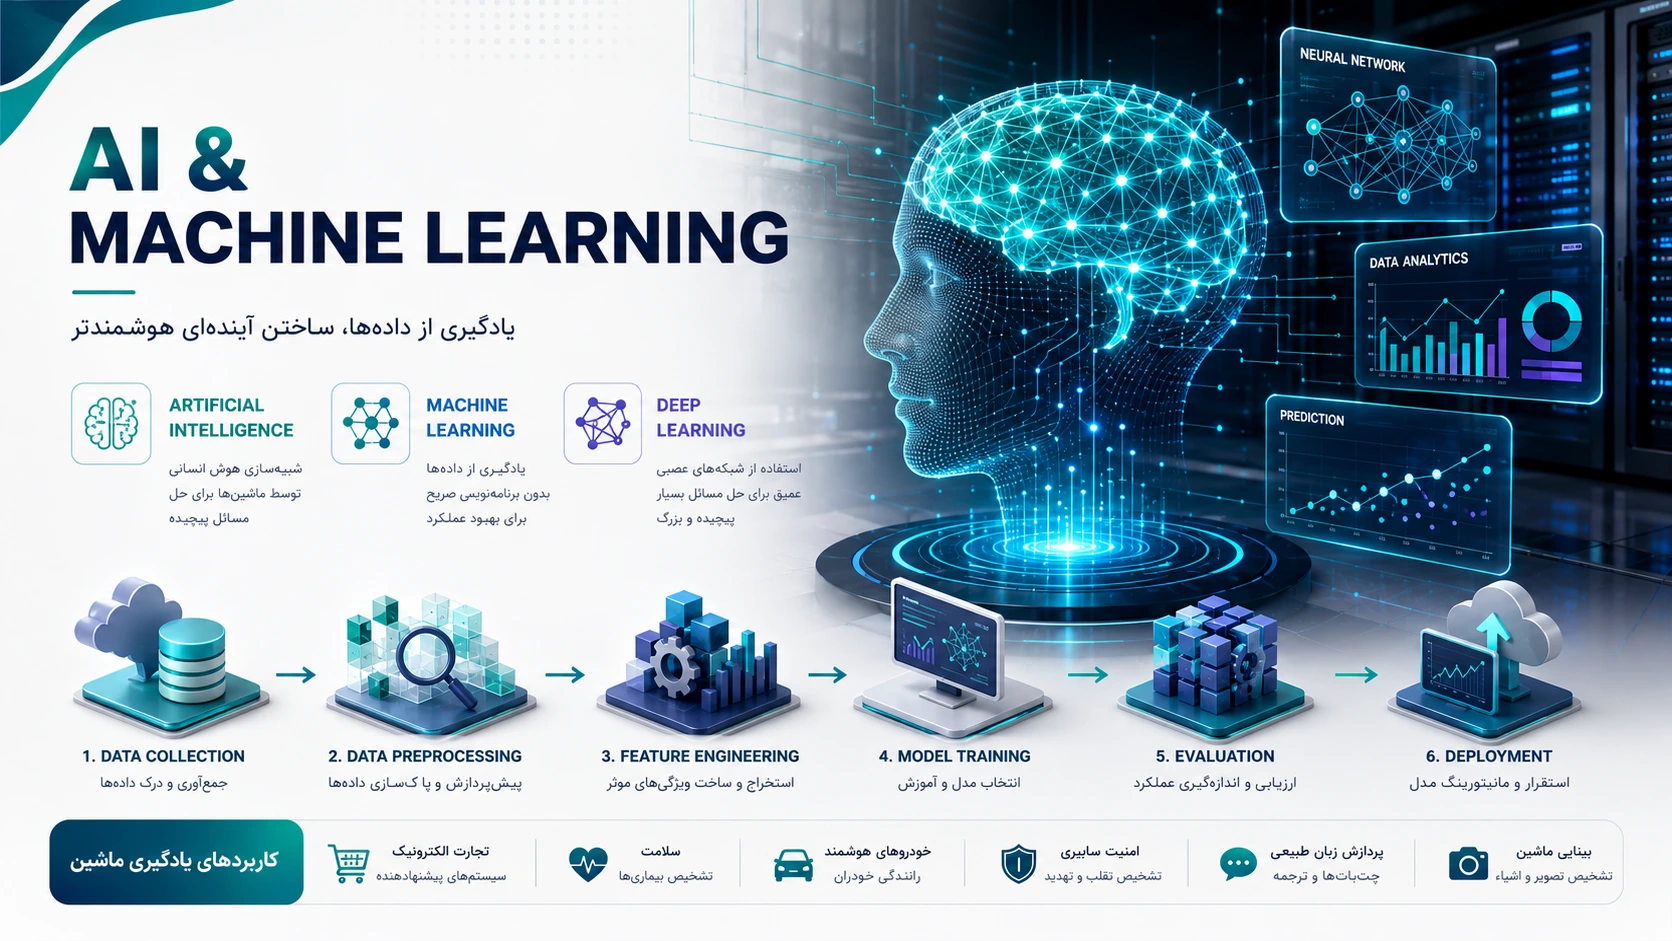
هوش مصنوعی گستردهترین مفهوم است که شامل هرگونه تکنولوژی است که تلاش میکند هوش انسانی را در ماشینها شبیهسازی کند. این میتواند شامل سیستمهای مبتنی بر قوانین ساده (If-Then) نیز باشد.
یادگیری ماشین (Machine Learning)
یادگیری ماشین زیرمجموعهای از هوش مصنوعی است. تمرکز اصلی آن بر توسعه الگوریتمهایی است که میتوانند از دادهها یاد بگیرند. به عبارت دیگر، یادگیری ماشین یعنی سیستم بدون اینکه مستقیماً برای یک وظیفه خاص برنامهنویسی شده باشد، با مشاهده دادهها بهبود مییابد.
یادگیری عمیق (Deep Learning)
یادگیری عمیق زیرمجموعهای از یادگیری ماشین است که از ساختارهای موسوم به شبکههای عصبی مصنوعی (Artificial Neural Networks) با لایههای متعدد استفاده میکند. این روش برای حل مسائل بسیار پیچیده مانند تشخیص گفتار و پردازش تصویر که الگوهای بسیار سطح بالا دارند، بسیار قدرتمند است.
"یادگیری ماشین، هنر استخراج دانش و الگوهای پنهان از دل انبوهی از دادههای خام است."
انواع اصلی یادگیری ماشین
الگوریتمهای یادگیری ماشین بر اساس نحوه یادگیری و نوع دادههای ورودی به سه دسته اصلی تقسیم میشوند:
۱. یادگیری با نظارت (Supervised Learning)
در این روش، مدل با دادههایی آموزش میبیند که دارای برچسب (Label) هستند. یعنی برای هر ورودی، پاسخ صحیح نیز مشخص شده است. هدف این است که مدل رابطه بین ورودی و خروجی را یاد بگیرد تا بتواند برای ورودیهای جدید، خروجی را پیشبینی کند. این دسته خود شامل دو زیرمجموعه مهم است:
- رگرسیون (Regression): زمانی که خروجی یک مقدار پیوسته است (مانند پیشبینی قیمت مسکن).
- طبقهبندی (Classification): زمانی که خروجی یک دسته یا کلاس مشخص است (مانند تشخیص ایمیل اسپم یا غیر اسپم).
۲. یادگیری بدون نظارت (Unsupervised Learning)
در یادگیری بدون نظارت، دادهها فاقد برچسب هستند. الگوریتم باید به تنهایی ساختارها، الگوها و گروههای پنهان را در دادهها پیدا کند. کاربردهای اصلی آن عبارتند از:
- خوشهبندی (Clustering): گروهبندی دادههای مشابه در گروههای مجزا (مانند بخشبندی مشتریان).
- کاهش ابعاد (Dimensionality Reduction): سادهسازی دادهها با حذف ویژگیهای غیرضروری بدون از دست دادن اطلاعات مهم.
۳. یادگیری تقویتی (Reinforcement Learning)
این روش بر اساس تعامل با محیط و مفهوم پاداش و جریمه است. یک عامل (Agent) در یک محیط قرار میگیرد و با انجام کنشهای مختلف، سعی میکند مجموع پاداشهای خود را بیشینه کند. این تکنولوژی در آموزش رباتها و بازیهای کامپیوتری بسیار کاربرد دارد.
چرخه حیات پروژه یادگیری ماشین (ML Pipeline)
یک پروژه یادگیری ماشین موفق تنها نوشتن کد نیست، بلکه شامل یک فرآیند مهندسی دقیق است که به آن Pipeline میگوییم:
مرحله ۱: جمعآوری و درک دادهها (Data Collection)
کیفیت مدل شما مستقیماً به کیفیت دادههای شما بستگی دارد. اگر دادههای شما ناقص یا سوگیرانه (Biased) باشند، مدل شما نیز خروجیهای اشتباه خواهد داشت. اصطلاح Garbage In, Garbage Out به خوبی این موضوع را توصیف میکند.
مرحله ۲: پیشپردازش دادهها (Data Preprocessing)
دادههای خام معمولاً کثیف هستند. در این مرحله عملیاتی نظیر پاکسازی دادههای پرت (Outliers)، مدیریت دادههای گمشده (Missing Values) و نرمالسازی (Normalization) انجام میشود.
مرحله ۳: مهندسی ویژگی (Feature Engineering)
این مرحله یکی از مهمترین و هنرمندانهترین بخشهای یادگیری ماشین است. در این مرحله، ما ویژگیهای جدیدی از دادههای موجود میسازیم که به مدل کمک کند الگوهای بهتر را شناسایی کند. برای مثال، در پیشبینی قیمت خانه، ترکیب "عرض" و "طول" زمین برای ساخت ویژگی "مساحت" بسیار مفید است.
مرحله ۴: انتخاب مدل و آموزش (Model Selection & Training)
در این مرحله، الگوریتم مناسب انتخاب شده و دادهها به آن داده میشوند تا پارامترهای داخلی آن تنظیم شوند. فرآیند آموزش شامل یافتن بهترین وزنها برای ورودیها جهت کمینه کردن خطا است.
... ادامه مقاله در وبسایت AUAZ.ir
گفتوگو
دیدگاهها(۰)