مقدمه: اهمیت وجود یک گردش کار مشخص در علم داده
در دنیای پیچیده امروز، علم داده تنها به معنای نوشتن چند خط کد برای اجرای یک الگوریتم یادگیری ماشین نیست. در واقع، موفقیت یک پروژه دادهمحور، بیش از آنکه به قدرت پردازشی وابسته باشد، به ساختار و نظم گردش کار (Workflow) بستگی دارد. بدون یک مسیر مشخص، دانشمندان داده ممکن است در دریایی از دادههای بیپایان غرق شوند یا مدلی بسازند که از نظر فنی دقیق اما از نظر تجاری بیارزش است.
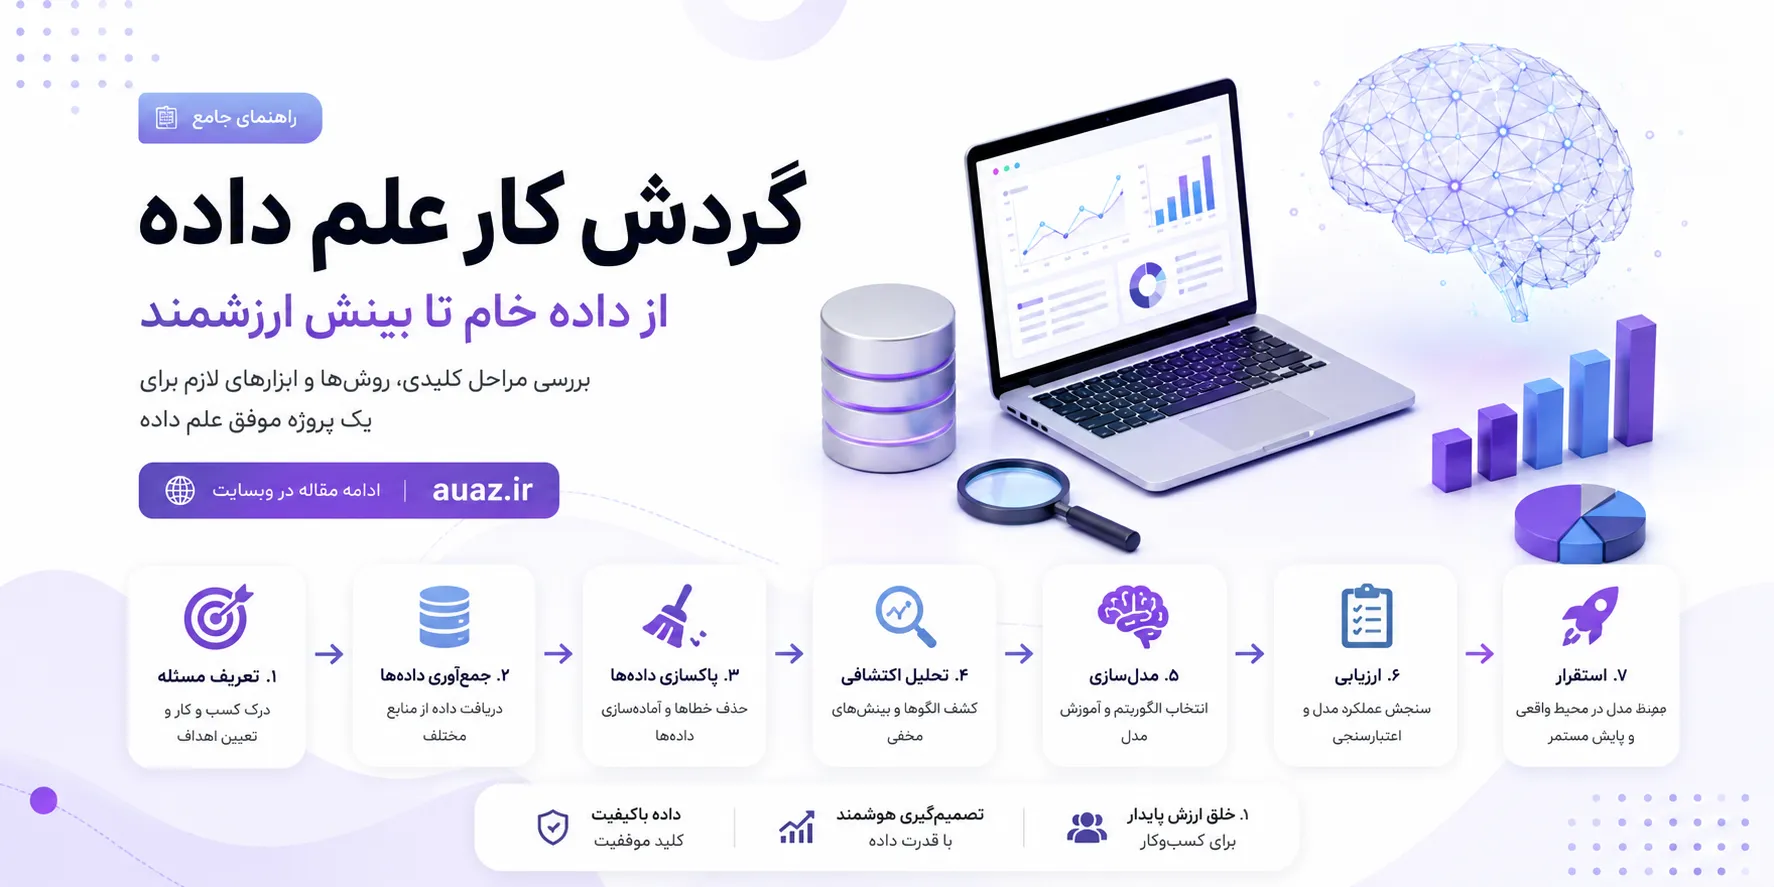
یک گردش کار استاندارد، مجموعهای از مراحل سیستماتیک است که از تعریف یک پرسش یا مسئله تجاری شروع شده و با ارائه یک راهکار قابل اجرا و پایش به پایان میرسد. در این مقاله، ما به بررسی دقیق هر یک از این مراحل و متدولوژیهای معتبری که این مسیر را هموار میکنند، خواهیم پرداخت.
۱. متدولوژیهای استاندارد: CRISP-DM و OSEMN
پیش از ورود به جزئیات فنی، باید بدانیم که متخصصان از چارچوبهای از پیش تعیین شدهای برای مدیریت پروژهها استفاده میکنند. دو مورد از معروفترین آنها عبارتند از:
مدل CRISP-DM
مدل CRISP-DM (Cross-Industry Standard Process for Data Mining) محبوبترین چارچوب در صنعت است. این مدل شامل ۶ مرحله اصلی است:
- درک کسبوکار (Business Understanding): هدف چیست؟
- درک دادهها (Data Understanding): چه دادههایی در دسترس داریم؟
- آمادهسازی دادهها (Data Preparation): تمیزکاری و آمادهسازی.
- مدلسازی (Modeling): انتخاب و اجرای الگوریتمها.
- ارزیابی (Evaluation): آیا مدل پاسخگوی نیاز کسبوکار هست؟
- استقرار (Deployment): ارائه مدل به محیط واقعی.
مدل OSEMN
این مدل که بیشتر بر جنبههای فنی و فرآیند داده تمرکز دارد، از مخفف کلمات زیر تشکیل شده است:
- Obtain: جمعآوری دادهها.
- Scrub: پاکسازی دادهها.
- Explore: تحلیل اکتشافی.
- Model: مدلسازی ریاضی.
- iNterpret: تفسیر نتایج و انتقال معنا به ذینفعان.
۲. مرحله اول: تعریف مسئله و درک دامنه (Problem Definition)
بسیاری از پروژههای علم داده به این دلیل شکست میخورند که تیم فنی دقیقاً نمیداند قرار است چه مشکلی را حل کند. در این مرحله، دانشمند داده باید با ذینفعان (Stakeholders) گفتگو کند تا اهداف را شفاف کند.
"اگر من بدانم چه میخواهم، هر راهی را برای رسیدن به آن پیدا خواهم کرد." - این جمله در علم داده به معنای تعریف دقیق KPIها (شاخصهای کلیدی عملکرد) است.
سوالاتی که باید پاسخ داده شوند:
- آیا این یک مسئله طبقهبندی (Classification) است یا رگرسیون (Regression)؟
- موفقیت پروژه با چه معیاری سنجیده میشود؟ (مثلاً کاهش نرخ ریزش مشتری یا افزایش دقت پیشبینی فروش).
- محدودیتهای زمانی و منابع چیست؟
۳. مرحله دوم: جمعآوری دادهها (Data Acquisition)
پس از مشخص شدن هدف، نوبت به یافتن منابع داده میرسد. دادهها میتوانند از منابع مختلفی تامین شوند:
- پایگاههای دادههای رابطهای (SQL): استخراج داده از سیستمهای ERP یا CRM.
- APIها: دریافت دادههای زنده از سرویسهای وب (مانند توییتر یا آبوهوا).
- Web Scraping: استخراج داده از صفحات وب با استفاده از ابزارهایی مانند
BeautifulSoupیاScrapy. - فایلهای ساختاریافته و غیرساختاریافته: شامل CSV، JSON، تصاویر و متون.
در این مرحله، کیفیت دادههای جمعآوری شده، تعیینکننده کیفیت نهایی مدل خواهد بود (اصل Garbage In, Garbage Out).
۴. مرحله سوم: پاکسازی و پیشپردازش دادهها (Data Cleaning)
گفته میشود که یک دانشمند داده بیش از ۸۰ درصد از زمان خود را صرف پاکسازی دادهها میکند. دادههای واقعی معمولاً کثیف، ناقص و دارای خطا هستند. فرآیند پاکسازی شامل موارد زیر است:
- مدیریت دادههای مفقود (Missing Values): حذف سطرها یا جایگزینی با میانگین/میانه.
- حذف دادههای تکراری (Duplicates): جلوگیری از سوگیری در مدل.
- شناسایی دادههای پرت (Outliers): تشخیص مقادیری که با توزیع کلی دادهها همخوانی ندارند.
- نرمالسازی و استانداردسازی (Scaling): تغییر مقیاس دادهها برای اینکه ویژگیهایی با اعداد بزرگتر، بر ویژگیهای کوچکتر غلبه نکنند.
مثال: اگر ویژگی «سن» بین ۰ تا ۱۰۰ و ویژگی «درآمد» بین ۱۰ میلیون تا ۱۰۰ میلیون باشد، مدل ممکن است به اشتباه فکر کند درآمد بسیار مهمتر است. با استفاده از MinMaxScaler این مشکل حل میشود.
۵. مرحله چهارم: تحلیل اکتشافی دادهها (Exploratory Data Analysis - EDA)
EDA مرحلهای است که در آن ما سعی میکنیم با دادهها «صحبت» کنیم. هدف این مرحله یافتن الگوها، همبستگیها و ساختارهای پنهان در دادههاست. از ابزارهای بصریسازی (Visualization) برای این کار استفاده میشود:
- نمودارهای هیستوگرام: برای درک توزیع یک ویژگی.
- نمودار پراکندگی (Scatter Plot): برای مشاهده رابطه بین دو متغیر.
- نقشه حرارتی (Heatmap):
... ادامه مقاله در وبسایت AUAZ.ir
گفتوگو
دیدگاهها(۰)