مقدمه: چرا گردشکار (Workflow) در علم داده حیاتی است؟
در دنیای پیچیده و پرشتاب امروز، دادهها به عنوان "نفت جدید" شناخته میشوند. اما نفت خام بدون پالایش میتواند بیشتر از آنکه مفید باشد، آسیبرسان باشد. در علم داده نیز، دادههای خام بدون طی کردن یک فرآیند ساختارمند، تنها مجموعهای از اعداد و حروف بیمعنا هستند. گردشکارهای علم داده (Data Science Workflows) مجموعهای از مراحل سیستماتیک هستند که یک دانشمند داده را از مرحله ایده و پرسشهای اولیه به مرحله ارائه پاسخهای عملیاتی و مدلهای پیشبینیکننده هدایت میکنند.
بدون داشتن یک گردش کار مشخص، پروژههای علم داده با مشکلاتی نظیر عدم تکرارپذیری (Reproducibility)، خطاهای ناخواسته در مدلسازی، و عدم تطابق نتایج با نیازهای واقعی کسبوکار مواجه میشوند. در این مقاله، ما به بررسی عمیق هر یک از این مراحل میپردازیم تا درک کنید چگونه یک پروژه از یک سوال ساده به یک سیستم هوشمند تبدیل میشود.
استاندارد CRISP-DM: ستون فقرات پروژههای داده
پیش از ورود به جزئیات، باید با یکی از محبوبترین متدولوژیها در این حوزه آشنا شویم: CRISP-DM یا "فرآیند استاندارد صنعتی برای دادهکاوی". این مدل بر این اصل استوار است که علم داده یک فرآیند خطی نیست، بلکه یک چرخه تکرارشونده (Iterative) است. در بسیاری از موارد، نتایج مرحله ارزیابی ممکن است شما را مجبور کند که دوباره به مرحله تعریف مسئله یا پاکسازی دادهها بازگردید.
"علم داده یک علم تجربی است؛ شما فرضیه میسازید، آزمایش میکنید و بر اساس نتایج، فرضیه خود را اصلاح میکنید."
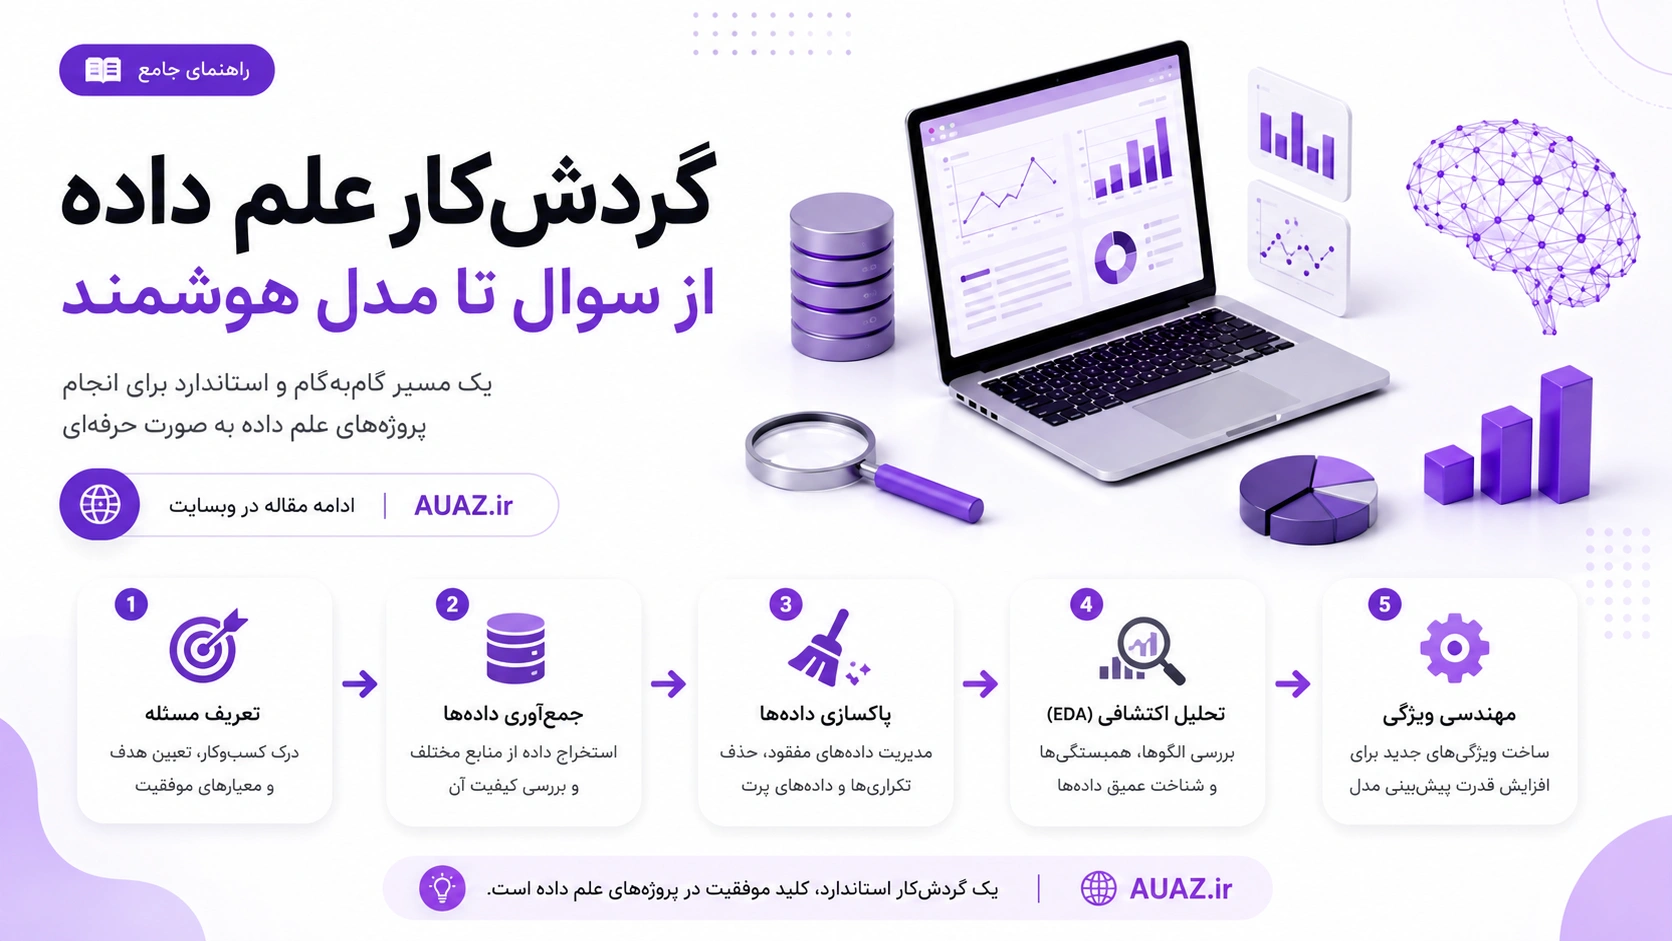
۱. مرحله تعریف مسئله و درک کسبوکار (Business Understanding)
بسیاری از پروژههای شکستخورده علم داده به این دلیل نیستند که الگوریتمهای ضعیفی داشتند، بلکه به این دلیل است که مشکل درستی را حل نمیکردند. اولین و مهمترین گام، تبدیل یک نیاز تجاری به یک مسئله ریاضی یا آماری است.
- شناسایی اهداف: هدف ما چیست؟ افزایش فروش؟ کاهش ریزش مشتری (Churn)؟ یا شناسایی تراکنشهای مشکوک؟
- تعریف معیارهای موفقیت: چگونه میفهمیم مدل ما موفق بوده است؟ آیا باید دقت (Accuracy) بالا باشد یا نرخ بازگشت سرمایه (ROI)؟
- محدودیتها: محدودیتهای زمانی، بودجهای و دسترسی به دادهها را مشخص کنید.
۲. مرحله جمعآوری دادهها (Data Acquisition)
پس از مشخص شدن مسئله، باید دادههای مورد نیاز را پیدا کنید. منابع داده میتوانند بسیار متنوع باشند:
- پایگاههای دادههای ساختاریافته: استفاده از SQL برای استخراج داده از RDBMSها.
- APIها: دریافت داده از سرویسهای آنلاین مانند توییتر یا هواشناسی.
- Web Scraping: استخراج داده از صفحات وب با استفاده از کتابخانههایی مثل
BeautifulSoupیاScrapy. - فایلهای غیرساختاریافته: پردازش متن (NLP) یا تصاویر (Computer Vision).
در این مرحله، دانشمند داده باید مراقب سوگیری در نمونهگیری (Sampling Bias) باشد تا دادهها نماینده واقعی جامعه مورد مطالعه باشند.
۳. مرحله پاکسازی و پیشپردازش دادهها (Data Cleaning & Preprocessing)
گفته میشود که دانشمندان داده ۸۰ درصد از زمان خود را صرف پاکسازی دادهها میکنند. این یک واقعیت تلخ اما ضروری است. دادههای واقعی کثیف، ناقص و گاهی متناقض هستند. فرآیند پاکسازی شامل موارد زیر است:
- مدیریت دادههای مفقود (Missing Values): آیا باید ردیفهای خالی را حذف کرد یا از روشهایی مانند Imputation (جایگزینی با میانگین یا میانه) استفاده کرد؟
- حذف دادههای پرت (Outliers): شناسایی مقادیری که به دلیل خطا در ثبت یا موارد استثنایی، تحلیل را منحرف میکنند.
- اصلاح ساختار دادهها: تبدیل انواع داده (مثلاً تبدیل رشته به تاریخ) و یکسانسازی واحدها.
- حذف دادههای تکراری: جلوگیری از اثر بیش از حد برخی دادهها بر مدل.
۴. مرحله تحلیل اکتشافی دادهها (Exploratory Data Analysis - EDA)
قبل از اینکه سراغ مدلهای پیچیده یادگیری ماشین برویم، باید دادهها را "بشناسیم". EDA فرآیندی است که در آن با استفاده از آمار توصیفی و نمودارها، الگوها و همبستگیها را کشف میکنیم. از ابزارهایی مانند Pandas، Matplotlib و Seaborn در پایتون برای این کار استفاده میشود.
در این مرحله، سوالات زیر پاسخ داده میشوند:
- آیا توزیع دادهها نرمال است؟
- کدام ویژگیها (Features) با متغیر هدف (Target) همبستگی بالایی دارند؟
- آیا خوشههای (Clusters) خاصی در دادهها مشاهده میشود؟
۵. مرحله مهندسی ویژگی (Feature Engineering)
این مرحله جایی است که هنر و علم داده با هم ترکیب میشوند. مهندسی ویژگی یعنی استفاده از دانش دامنه (Domain Knowledge) برای ساخت ویژگیهای جدید از دادههای موجود که قدرت پیشبینی مدل را افزایش میدهند.
مثالها:
- در یک پروژه پیشبینی قیمت خانه، به جای استفاده از "تاریخ ساخت"، ویژگی جدیدی به نام "عمر ساختمان" بسازیم.
- در دادههای زمانی، استخراج "روز هفته" یا "فصل" برای شناسایی الگوهای فصلی.
- استفاده از تکنیکهای
One-Hot Encodingبرای تبدیل متغیرهای دستهای به اعداد.
... ادامه مقاله در وبسایت AUAZ.ir
گفتوگو
دیدگاهها(۰)